인터프리터 패턴: 문법을 클래스 트리로 해석하는 원리
인터프리터 패턴은 GoF가 정의한 행위 패턴으로, 문법 규칙마다 클래스를 만들어 문장을 표현식 트리로 조립하고 재귀로 평가한다. 단순한 문법에 알맞고 복잡하면 파서 제너레이터가 낫다는 점, 자바 정규식과 스프링 SpEL의 실제 쓰임까지 짚는다.
목차
인터프리터 패턴은 특정 문법(문장을 구성하는 규칙의 집합)을 클래스로 표현하고, 그 문법으로 쓰인 문장을 객체 트리로 조립해 재귀로 해석하는 설계 방식이다. GoF(Gang of Four)가 1994년 저서 『Design Patterns』에서 정리한 23개 패턴 중 하나이며, 행위(behavioral) 패턴으로 분류된다. 핵심은 "문법 규칙 하나당 클래스 하나"를 만들어, 규칙이 서로를 품는 구조를 그대로 객체의 포함 관계로 옮긴다는 데 있다.
이 글은 패턴의 개념과 내부 동작, 그리고 실무에서 언제 쓰고 언제 피해야 하는지를 자바 예제와 함께 다룬다. 파서·컴파일러 이론 전반이 아니라, 애플리케이션 코드 안에서 작은 규칙 언어를 다뤄야 할 때 이 패턴이 어떤 선택지인지에 초점을 맞춘다.
인터프리터 패턴이란 무엇인가
출발점은 "문법"이다. 여기서 문법은 사람이 쓰는 자연어의 문법이 아니라, 우리가 다루려는 작은 규칙 언어를 이루는 규칙들을 뜻한다. 예를 들어 "VIP이면서 구매액이 높거나, 직원이면 할인 대상"이라는 조건은 그 자체로 하나의 미니 언어다. 여기에는 변수(VIP, 직원), 논리 연산(그리고, 또는), 그리고 이들을 조합하는 규칙이 들어 있다.
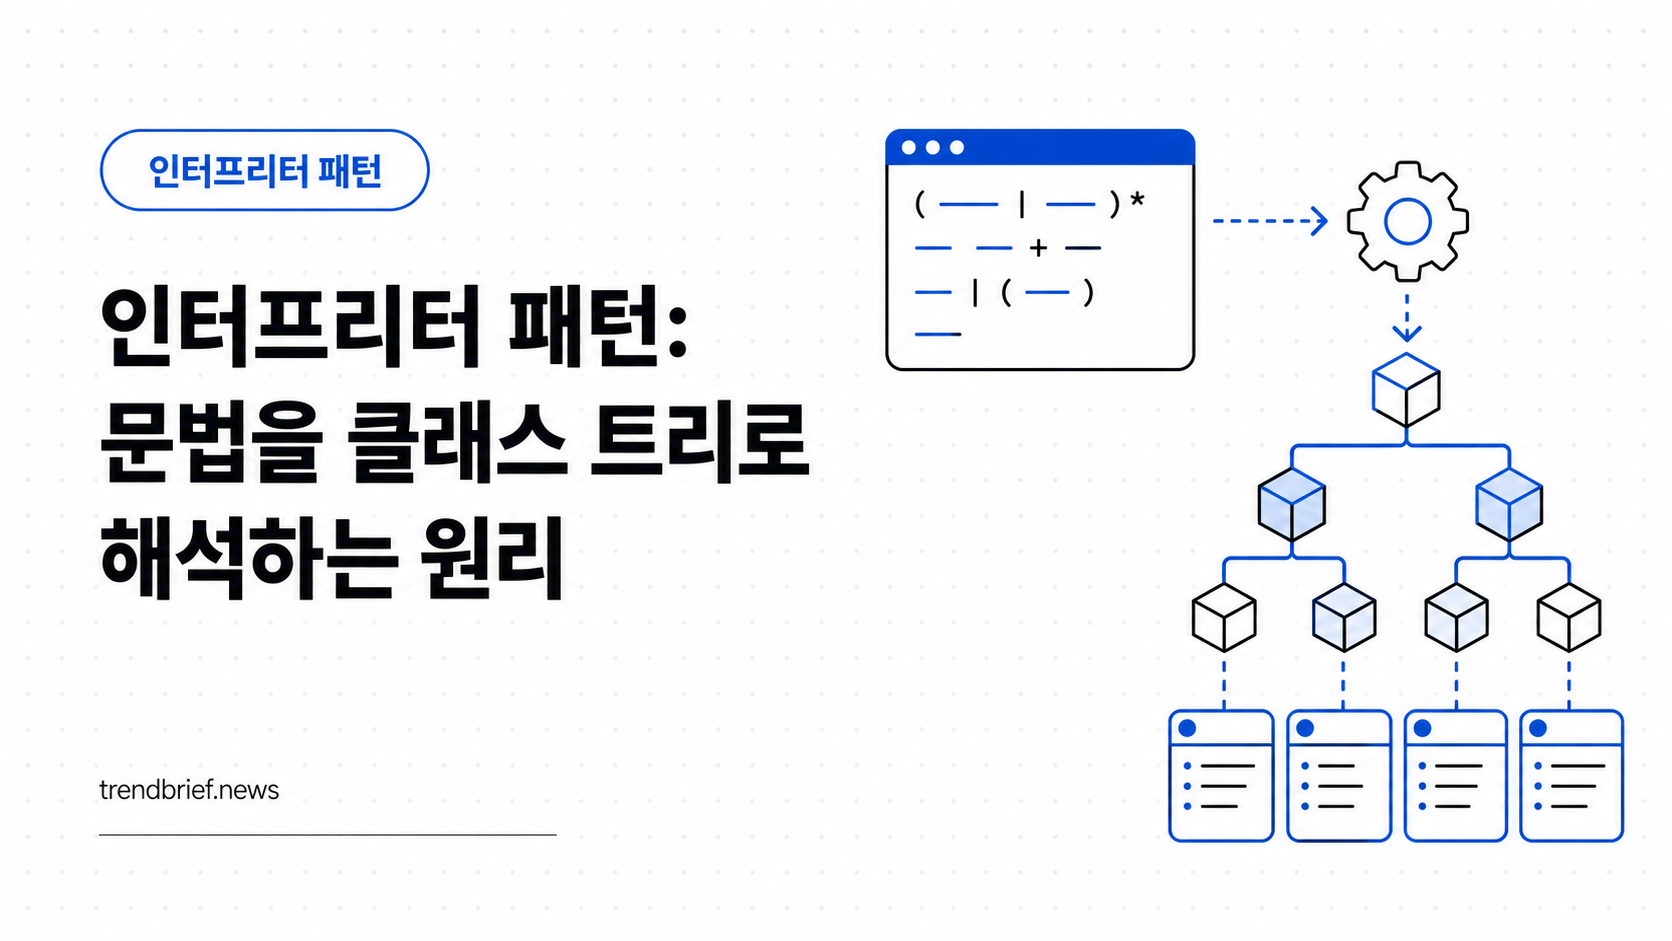
인터프리터 패턴은 그런 규칙 하나하나를 클래스로 만든다. 변수는 변수 클래스, AND는 AND 클래스, OR는 OR 클래스가 된다. 실제 문장은 이 클래스들의 인스턴스를 조립한 트리(tree, 가지처럼 뻗어 나가는 계층 구조)로 표현된다. 문장을 해석한다는 것은 이 트리의 뿌리에서 잎까지 값을 계산해 내려간다는 뜻이다. 이렇게 만든 트리를 컴파일러 분야에서는 추상 구문 트리(AST, Abstract Syntax Tree — 코드나 문장의 구조를 나무 모양으로 표현한 것)라고 부른다.
GoF는 이 패턴을 행위 패턴으로 분류한다. 행위 패턴은 객체들이 책임을 어떻게 나누고 서로 어떻게 협력하는지를 다루는 갈래다. 인터프리터 패턴에서는 "해석"이라는 책임을 규칙 클래스들이 나눠 갖고, 각자 자기 몫만 처리한 뒤 나머지는 하위 규칙에 넘긴다. 그래서 규칙이 몇 개뿐이어도 이들을 겹겹이 조합하면 상당히 복잡한 조건까지 표현할 수 있다.
다섯 참여자가 문법을 나눠 맡는다
GoF의 원래 정의에서 인터프리터 패턴은 다섯 종류의 참여자로 이뤄진다. 이름은 낯설지만 역할은 단순하다.
| 참여자 | 역할 |
|---|---|
| AbstractExpression | 모든 표현식이 공유하는 interpret() 연산을 선언 |
| TerminalExpression | 더 쪼갤 수 없는 말단 기호(변수, 리터럴)를 해석 |
| NonterminalExpression | 하위 표현식을 품고 재귀로 해석하는 규칙(AND, OR 등) |
| Context | 해석에 필요한 외부 정보(입력 문자열, 변수 값) |
| Client | 문장 구조에 맞게 표현식 트리를 조립하고 루트에서 interpret() 호출 |
여기서 핵심 구분은 말단 표현식과 비말단 표현식이다. 말단(terminal) 표현식은 트리의 잎에 해당해 더 이상 쪼개지지 않는다. 변수나 숫자 리터럴이 여기에 속한다. 비말단(nonterminal) 표현식은 트리의 가지에 해당해 하위 표현식을 품고, 자기 자식들을 먼저 해석한 뒤 그 결과를 합친다. AND, OR, 사칙연산 같은 규칙이 비말단이다. 이 재귀적 포함 관계 덕분에 규칙 몇 개만으로 임의로 깊은 문장을 표현할 수 있다.
표현식 트리 자체는 새로운 아이디어가 아니다. 하위 요소를 품는 가지와 더 이상 나뉘지 않는 잎을 같은 인터페이스로 다룬다는 점에서, 인터프리터 패턴의 트리는 Composite(복합체) 패턴의 구조를 문법에 적용한 것이다. GoF도 두 패턴의 구조적 유사성을 함께 설명한다.
코드로 보는 해석 과정
앞의 조건 규칙을 자바로 옮겨 보자. 먼저 모든 표현식이 공유할 interpret() 연산을 인터페이스로 선언하고, 변수·AND·OR를 각각 구현한다.
// 표현식: 모든 노드가 공유하는 해석 연산
interface Expression {
 boolean interpret(Map<String, Boolean> context);
}

// 말단(터미널) 표현식: 변수 하나를 문맥에서 읽는다
class Variable implements Expression {
 private final String name;
 Variable(String name) { this.name = name; }
 public boolean interpret(Map<String, Boolean> ctx) {
  return ctx.getOrDefault(name, false);
 }
}

// 비말단 표현식: 하위 표현식 둘을 AND로 묶는다
class And implements Expression {
 private final Expression left, right;
 And(Expression left, Expression right) { this.left = left; this.right = right; }
 public boolean interpret(Map<String, Boolean> ctx) {
  return left.interpret(ctx) && right.interpret(ctx);
 }
}

// OR도 같은 모양, 연산자만 || 로 바뀐다
class Or implements Expression {
 private final Expression left, right;
 Or(Expression left, Expression right) { this.left = left; this.right = right; }
 public boolean interpret(Map<String, Boolean> ctx) {
  return left.interpret(ctx) || right.interpret(ctx);
 }
}
Variable은 말단 표현식이라 문맥(Context)에서 값을 그대로 읽는다. 여기서 Context 역할은 Map<String, Boolean>이 맡는다 — 변수 이름과 참·거짓 값을 담은 외부 정보다. And와 Or는 비말단 표현식으로, 자기 자식 두 개의 interpret()를 먼저 호출한 다음 결과를 논리 연산으로 합친다.
이제 클라이언트(Client)가 규칙을 트리로 조립하고 루트에서 해석을 시작한다.
// (vip AND highValue) OR staff 규칙을 트리로 조립
Expression rule = new Or(
 new And(new Variable("vip"), new Variable("highValue")),
 new Variable("staff"));

Map<String, Boolean> ctx = Map.of(
 "vip", true, "highValue", false, "staff", false);

boolean granted = rule.interpret(ctx); // 결과: false
호출 과정을 따라가 보자. rule.interpret(ctx)는 Or의 interpret()를 부른다. Or는 왼쪽 가지인 And를 먼저 부르고, And는 두 Variable을 부른다. Variable("vip")은 true, Variable("highValue")는 false를 돌려주므로 And의 결과는 true AND false, 곧 false다. 이어 Or는 오른쪽 Variable("staff")를 부르는데 값이 false라, 최종 결과는 false OR false로 false가 된다. 호출은 잎까지 내려갔다가 값을 들고 거슬러 올라온다.
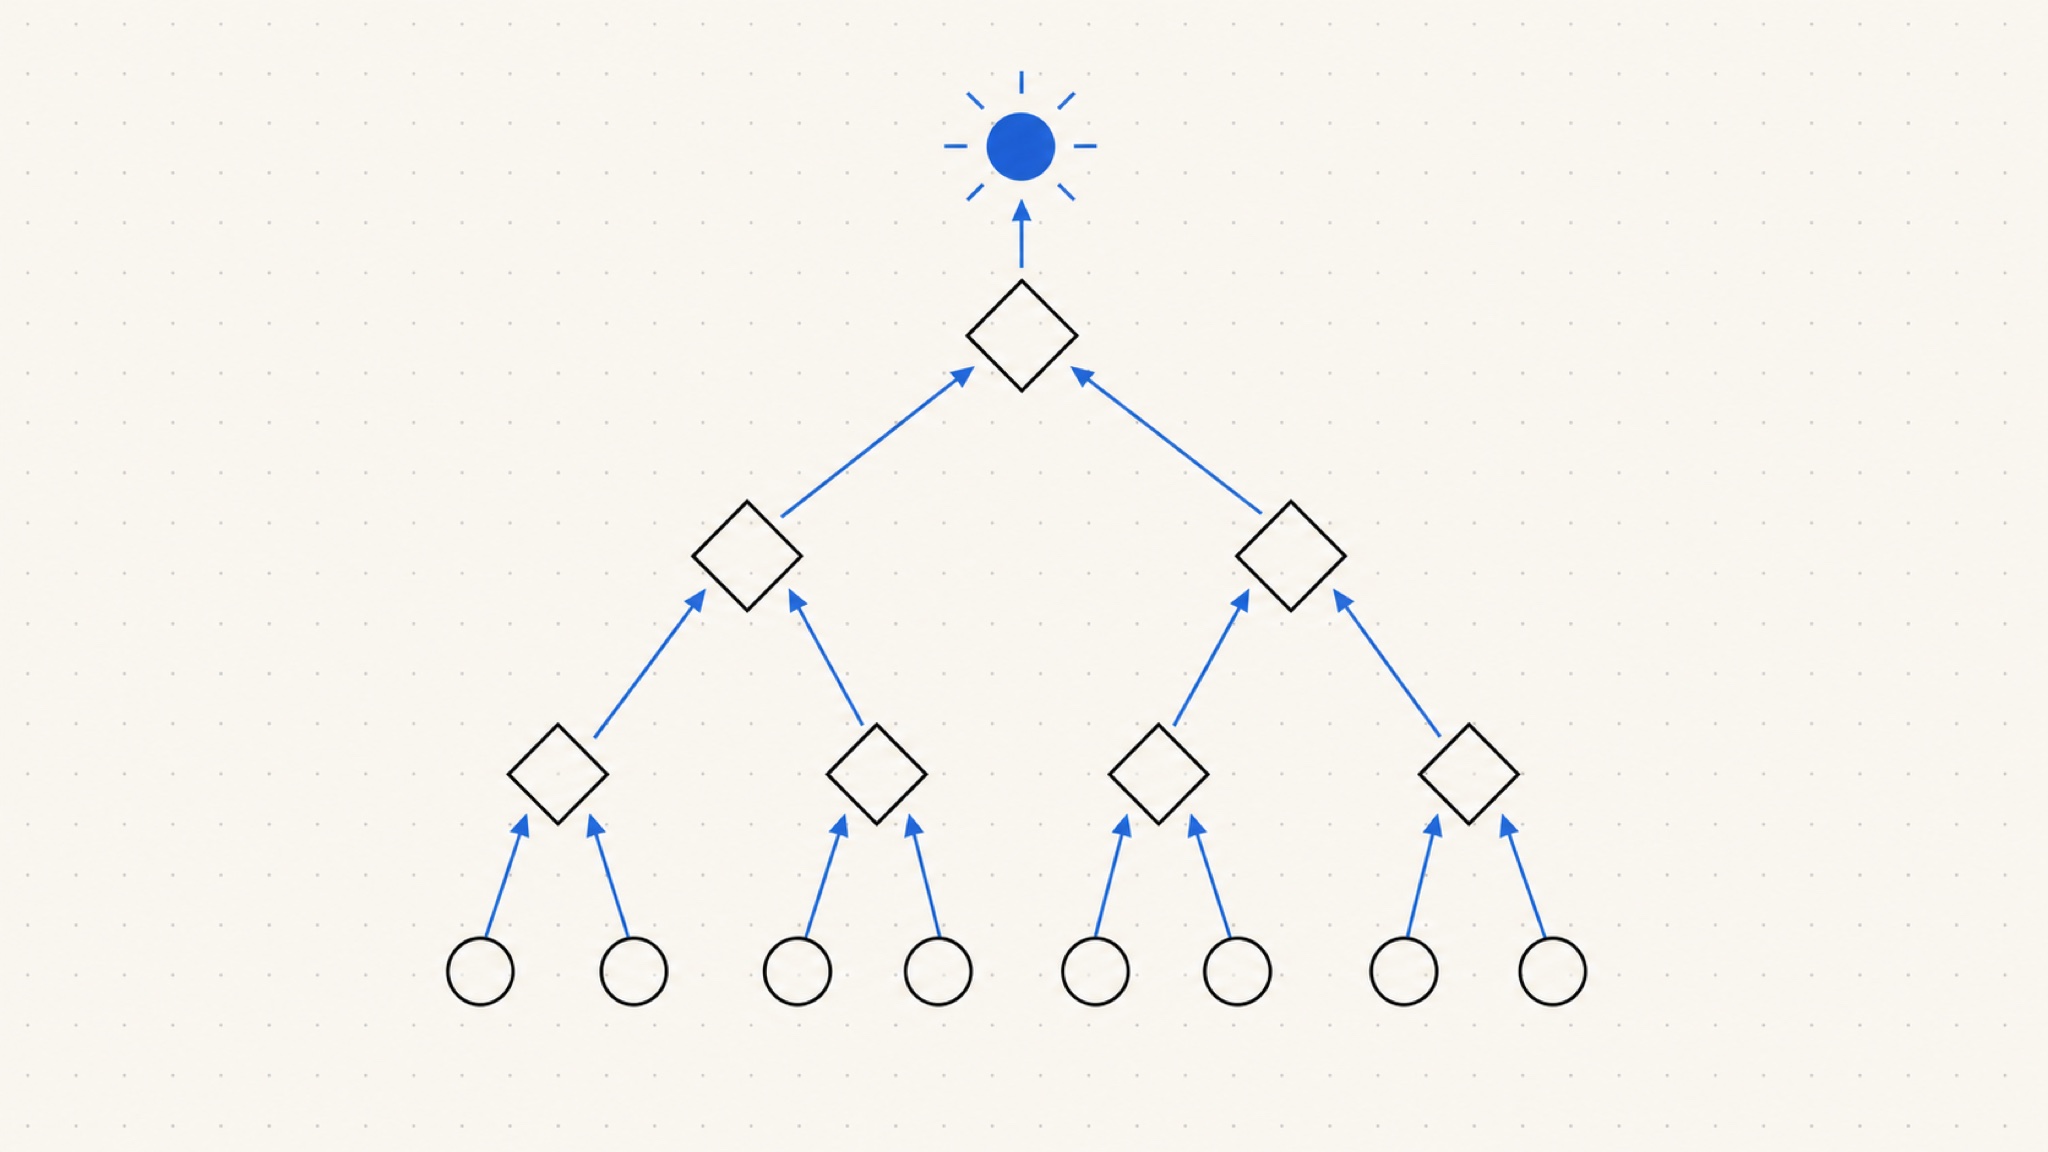
루트에서 자식으로 재귀 호출이 뻗어 내려가는 이 흐름은 이진 트리를 순회하며 각 노드에서 값을 계산하는 방식과 구조가 같다. 규칙을 더 작은 규칙으로 쪼갠 뒤 각각 해석해 합치는 발상 역시 문제를 분할해 정복하는 재귀적 사고의 한 갈래다.
주목할 점은 새 연산을 더하기 쉽다는 것이다. NOT 규칙이 필요하면 Expression을 구현한 Not 클래스 하나만 만들면 된다. 기존 Variable·And·Or 코드는 건드리지 않는다. 규칙 하나가 클래스 하나에 갇혀 있어, 규칙을 늘리는 확장에는 열려 있고 기존 규칙의 변경에는 닫혀 있는 구조가 자연스럽게 나온다.
인터프리터 패턴은 언제 써야 하나
문법이 단순하고 같은 종류의 규칙을 반복해서 평가해야 할 때가 적기다. GoF는 어떤 문제가 자주 반복되면 그 문제를 단순한 언어의 문장으로 표현하고, 그 문장을 해석하는 방식으로 풀 수 있다고 설명한다. 조건부 할인 규칙, 검색 필터식, 접근 권한 규칙처럼 규칙을 데이터처럼 조립했다가 실행하고 싶은 상황이 대표적이다. 예를 들어 관리자 화면에서 사용자가 만든 필터를 저장해 두었다가 나중에 재실행해야 한다면, 필터를 문자열로 남겼다가 매번 파싱하는 대신 표현식 트리로 세워 두는 편이 다루기 깔끔하다.
반대로 문법이 복잡해지면 이 패턴은 급격히 불리해진다. GoF는 문법 규칙 하나마다 최소 한 개의 클래스가 필요하다고 지적한다. BNF(문법을 형식적으로 적는 표기법)로 규칙을 정의하면 규칙 하나가 여러 클래스로 갈라지기도 한다. 규칙이 수십 개를 넘어가면 클래스 계층이 손대기 어려울 만큼 커진다. 『Design Patterns』는 이런 복잡한 문법에는 인터프리터 패턴 대신 파서 제너레이터 같은 도구가 낫다고 본다. 파서 제너레이터는 문법 정의로부터 해석 코드를 자동으로 만들어 주므로, 표현식마다 클래스를 손으로 쓰는 수고를 덜어 준다.
| 기준 | 인터프리터 패턴 | 파서 제너레이터 |
|---|---|---|
| 문법 규모 | 규칙 10개 안팎의 단순 문법 | 규칙 수십 개 이상의 복잡 문법 |
| 구현 방식 | 규칙마다 손으로 클래스 작성 | 문법 정의에서 코드 자동 생성 |
| 유지보수 | 규칙 늘면 클래스 폭증 | 문법 파일만 수정 |
| 대표 예 | 규칙 엔진, 조건식 평가 | ANTLR, yacc/bison |
판단 기준은 규칙의 개수와 변화 속도다. 규칙이 열 개 안팎이고 애플리케이션 안에서 직접 다루고 싶다면 인터프리터 패턴이 잘 맞는다. 규칙이 언어 수준으로 커지고 문법 자체가 자주 바뀐다면 ANTLR 같은 파서 제너레이터나 이미 검증된 표현식 엔진을 쓰는 편이 유지보수 부담이 적다.
정규식과 SpEL도 인터프리터 패턴인가
맞다. 매일 쓰는 도구 안에 이 패턴이 들어 있다. 대표적인 예가 자바의 정규식이다. 오라클 자바 공식 문서에 따르면 정규식 문자열은 먼저 java.util.regex.Pattern 인스턴스로 컴파일되고, 이 Pattern으로 Matcher 객체를 만들어 실제 입력 문자열과 대조한다. 같은 정규식을 여러 번 쓸 때 Pattern.compile()로 한 번 컴파일해 재사용하라고 권하는 것도 이 문서다. 정규식이라는 규칙 언어를 객체 구조로 컴파일해 두고 그 구조가 입력을 해석한다는 점에서, 인터프리터 패턴이 자주 인용되는 사례다.
스프링 프레임워크의 SpEL(Spring Expression Language)도 같은 결이다. 스프링 공식 문서에 따르면 SpEL은 런타임에 객체 그래프를 조회·조작하는 표현식 언어이며, ExpressionParser가 표현식 문자열을 파싱해 Expression 객체로 만든 뒤 그것을 평가한다. 스프링이 내부에서 이 파싱 결과를 org.springframework.expression.spel.ast 패키지의 AST 노드들로 표현한다는 사실은, 문장을 표현식 트리로 조립한다는 패턴의 골격이 실제 프레임워크에 그대로 쓰였음을 보여 준다.
공식 레퍼런스는 각각 오라클 자바 Pattern 문서와 스프링 SpEL 문서에서 확인할 수 있다. 두 사례의 공통점은 규칙을 매번 문자열로 재해석하지 않고 한 번 구조로 바꿔 둔 뒤 반복 사용한다는 데 있다. 우리가 직접 이 패턴을 손으로 구현하는 경우는 드물어도, 이런 도구를 쓸 때마다 그 안의 인터프리터 구조를 간접적으로 활용하는 셈이다.
도입 전 점검할 것
인터프리터 패턴의 장점은 문법과 코드가 일대일로 대응한다는 점이다. 규칙이 곧 클래스라, 새 규칙을 더하거나 규칙의 해석 방식을 바꾸기 쉽다. 규칙을 데이터처럼 저장했다가 런타임에 조립하는 유연함도 얻는다.
단점도 분명하다. 규칙 수가 늘면 클래스가 그만큼 늘어 전체 구조를 파악하기 어려워진다. 트리를 재귀로 훑는 방식은 규칙이 깊게 중첩되면 호출 스택이 그만큼 깊어지므로, 입력의 중첩 깊이가 통제되는지 확인해야 한다. 사용자가 임의로 깊은 표현식을 던질 수 있는 환경이라면 스택 오버플로를 막을 깊이 제한이 필요하다. 해석 로직이 표현식 클래스마다 흩어지는 것도 부담이다. 해석 말고 출력·검증 같은 연산까지 늘어난다면, 연산을 클래스 밖으로 빼내는 방문자(Visitor) 패턴을 함께 쓰는 방안을 검토할 만하다.
실제로 도입을 결정하기 전에 다음을 자문해 보면 좋다.
- 다뤄야 할 규칙의 종류가 열 개 안팎으로 한정되는가, 아니면 계속 늘어날 언어 수준인가.
- 이 규칙 언어를 직접 정의하고 유지할 것인가, 이미 있는 표현식 엔진으로 대체할 수 있는가.
- 입력의 중첩 깊이가 예측 가능한가, 사용자 입력이 임의로 깊어질 수 있는가.
- 해석 말고도 표현식마다 수행할 연산이 앞으로 더 생길 것 같은가.
규칙이 적고, 내가 직접 다루고 싶고, 깊이가 통제된다는 답이 나온다면 인터프리터 패턴은 잘 맞는 도구다. 반대라면 파서 제너레이터나 검증된 라이브러리로 방향을 트는 편이 낫다. 결국 이 패턴은 규칙을 코드로 굳혀 다루는 작은 언어를 위한 도구이지, 본격적인 언어 처리를 위한 도구가 아니라는 점을 기억하면 선택이 어렵지 않다.